
서울대 연구팀, 지시 이해하고 미래 장면 예측하는 통합 로봇 AI 개발
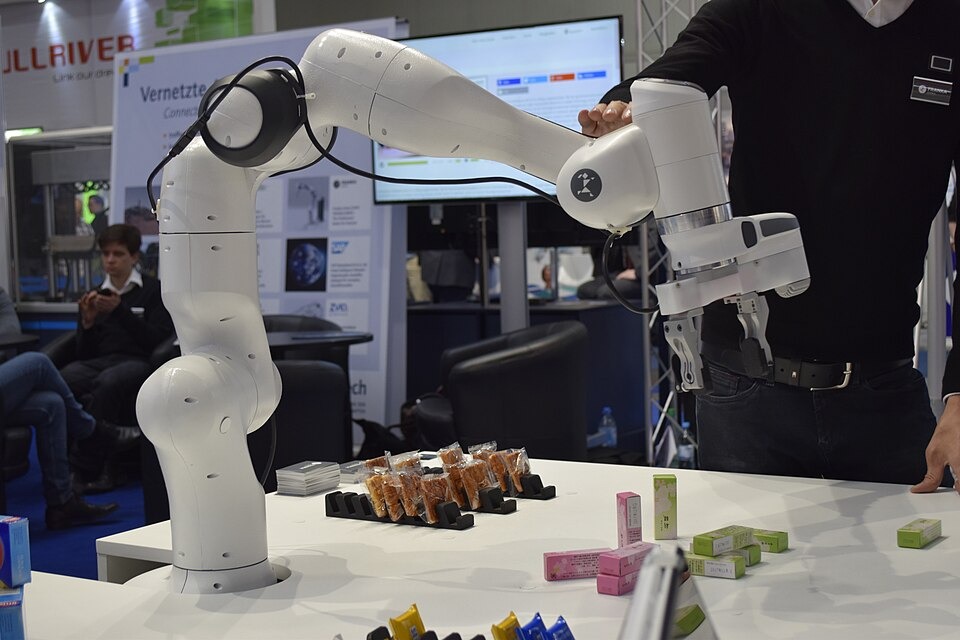
사람의 지시를 알아듣고 다음 장면을 예상하면서 움직임까지 결정하는 로봇 인공지능이 개발됐다. 서울대학교 공과대학 전기·정보공학부 도재영 교수팀은 자체 개발한 대규모언어모델 ‘Dynin-Omni’를 바탕으로 지시 이해, 미래 장면 예측, 행동 생성을 하나로 통합한 ‘Dynin-Robotics’를 제시했다.
이 기술은 비전·언어·행동 모델, 즉 VLA에 속한다. VLA는 로봇 카메라에 들어온 장면과 사람이 말이나 글로 내린 지시를 실제 로봇 제어값으로 연결하는 인공지능이다. 로봇이 무엇을 보고 있는지 파악하고, 요청받은 일이 무엇인지 이해한 뒤, 팔과 집게를 어떻게 움직일지 결정하는 과정을 묶는 방식이다.
기존 계열은 대체로 비전·언어 모델에 별도의 행동 모듈을 붙이거나, 영상 생성 모델로 미래 장면을 먼저 예측한 다음 행동 모델과 결합했다. Dynin-Robotics는 언어와 현재·미래 장면, 목표 장면, 로봇 행동을 모두 공통된 이산 토큰으로 표현한다. 이산 토큰은 문장이나 영상, 동작을 인공지능이 다룰 수 있는 일정한 단위로 나눈 값이다.
연구진은 이를 하나의 양방향 마스크 확산 모델에서 처리했다. 마스크 확산은 결과를 왼쪽부터 한 토큰씩 만드는 자기회귀 방식과 달리, 여러 가려진 위치를 동시에 예측하고 불확실한 값을 반복해 고치는 방식이다. 같은 모델이 조건을 달리해 로봇 행동 생성, 다음 장면 예측, 목표 장면 생성, 작업 영상에 대한 문장 설명을 수행하도록 설계됐다.
논문에 따르면 연구진은 Open X-Embodiment에 포함된 48개 데이터셋과 약 133만 개의 로봇 궤적을 이용해 모델을 지속 사전학습했다. 로봇 궤적은 로봇이 작업하면서 관찰한 장면과 취한 동작의 흐름을 뜻한다. 시뮬레이션 평가에서는 LIBERO 평균 성공률 98.1%를 기록했고, 추가 학습 없이 평가한 LIBERO-Plus에서는 73.0%를 나타냈다.
실제 Franka Research 3 로봇을 이용한 네 가지 조작 조건의 평균 성공률은 78.4%였다. 과일 집어 옮기기는 97.5%, 색상별 큐브 분류는 85.5%, 자유로운 순서의 큐브 쌓기는 62.0%, 지정된 색상 순서대로 쌓기는 68.5%였다. 단순히 물체를 옮기는 작업보다 여러 단계와 순서를 따라야 하는 작업에서 성공률이 낮아지는 모습도 수치로 확인됐다.
비교 결과는 모든 조건에서 Dynin-Robotics가 앞선 것은 아니었다. 평균 성공률은 피지컬 인텔리전스의 π0.5보다 1.5%포인트 높았지만, 자유 순서 쌓기에서는 1.5%포인트 낮았고 지정 순서 쌓기에서는 4.5%포인트 높았다. 엔비디아의 Cosmos Policy는 과일 옮기기 98.0%, 큐브 분류 87.0%, 자유 순서 쌓기 67.5%로 각각 Dynin-Robotics보다 높은 성공률을 보였다.
따라서 이번 결과는 한 모델이 모든 작업에서 일관되게 우세했다기보다, 언어로 행동 순서를 정해 주는 조건에서 상대적인 강점이 나타난 것으로 해석할 수 있다. 특히 지정 색상 순서 쌓기처럼 지시의 순서를 행동에 반영해야 하는 과제는 언어 이해와 로봇 제어를 하나의 구조에서 다루려는 연구 방향을 보여준다.
이번 연구는 한국연구재단 이공분야 기초연구사업 우수신진 지원을 받았다. 연구 논문은 인공지능·기계학습 분야 국제학술대회 NeurIPS 2026에 채택됐으며, 공식 논문 목록에서도 제목이 확인됐다. 논문은 arXiv에도 공개돼 모델 구조와 시뮬레이션·실제 로봇 평가 결과를 담고 있다.
자료: 서울대학교 공과대학, 서울대학교 AIDAS 연구실, NeurIPS, arXiv