
로봇의 눈을 빠르게 읽는 AI ‘F³’…이벤트 표현 초당 최대 440회 생성
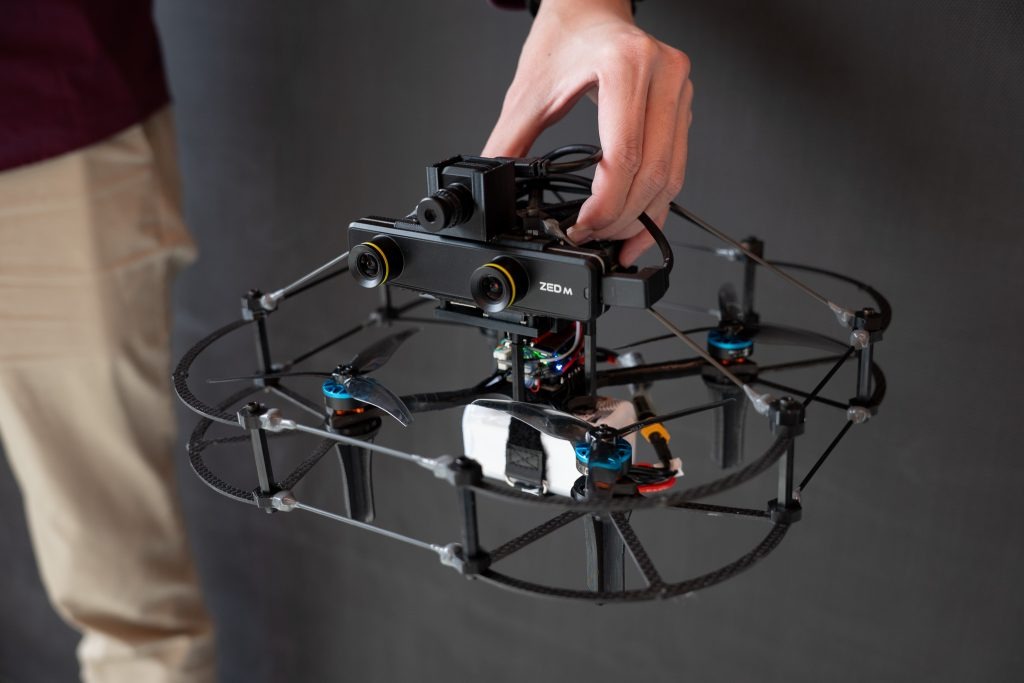
움직임이 빠르거나 밝기가 급격히 달라지는 곳에서도 로봇이 주변을 재빨리 파악하도록 돕는 인공지능 기술이 나왔다. 미국 펜실베이니아대학교 공과대학 연구진은 이벤트 카메라가 쏟아내는 시각 신호를 효율적으로 정리해 기존 컴퓨터비전 모델에 전달하는 ‘Fast Feature Field(F³)’를 개발했다.
일반 카메라는 일정한 시간 간격마다 화면 전체를 사진처럼 기록한다. 이벤트 카메라는 이와 달리 각 픽셀의 로그 밝기가 정해진 문턱값 이상 변할 때만 비동기 신호를 보낸다. 변화가 일어난 위치와 시점을 중심으로 기록하기 때문에 빠른 움직임을 포착하는 데 적합하다. 논문에 따르면 시간해상도는 100마이크로초 미만이고 동적 범위는 80~120데시벨(dB)이다. 짧은 순간의 변화와 밝고 어두운 영역의 차이를 폭넓게 다룰 수 있다는 뜻이다.
문제는 데이터의 양과 형태다. 이벤트 카메라는 초당 약 5000만 개의 이벤트를 만들 수 있어 잡음과 중복을 걸러내는 과정이 필요하다. HD 이벤트 데이터를 1밀리초 단위의 3차원 격자인 복셀로 바꾸면 초당 약 8억5000만 개가 생성되지만, 일반 환경에서는 그 가운데 약 95%가 비어 있다. 빈 좌표까지 모두 계산하면 로봇이 즉시 판단해야 하는 상황에서 처리 부담이 커진다.
F³는 기본적으로 과거 20밀리초 동안 발생한 이벤트를 입력받고, 사건이 없는 좌표는 계산에서 제외한다. 과거의 이벤트로 미래 이벤트를 예측하도록 학습해 장면의 구조와 움직임을 함께 담는다. 이렇게 만든 결과는 기존 RGB 카메라용 컴퓨터비전 모델이 다룰 수 있는 다채널 이미지 형태로 변환된다. 이벤트 카메라를 위한 별도 인식 체계를 매번 새로 만드는 대신, 이미 개발된 영상 분석 모델과 연결할 수 있도록 한 것이다.
F³ 자체가 이벤트 표현을 만드는 속도는 HD 해상도에서 초당 120회, VGA 해상도에서 초당 440회다. 다만 ‘초당 440회’는 로봇의 전체 시각 판단 속도가 아니라 이벤트 표현의 생성 속도다. 의미분할, 광류, 단안 깊이추정처럼 물체의 종류와 움직임, 거리를 알아내는 후속 작업까지 포함한 실제 추론 속도는 HD 기준 25~75Hz로 측정됐다.
연구진이 제시한 ‘2~5배 빠른 처리’도 모든 로봇과 하드웨어에서 항상 보장되는 수치가 아니다. 의미분할·광류·깊이추정의 특정 벤치마크에서 기존 최신 방법과 비교한 결과다. 연구진은 자동차와 사족보행 로봇, 비행 플랫폼에서 수집한 MVSEC 약 0.4시간, DSEC 약 0.9시간, M3ED 약 3.4시간 분량의 데이터로 기술을 평가했다. M3ED에는 1280×720 해상도 이벤트 카메라와 라이다, RGB 카메라의 동기화 데이터가 포함됐다.
시험 범위에는 낮과 밤, 실내와 실외, 도시와 비포장 환경이 들어갔다. 연구진은 해상도와 이벤트 발생률이 서로 다른 센서에서도 추가 학습 없이 일반화되는지를 살폈다. 이는 한 종류의 카메라나 한정된 주행 조건에만 맞춘 표현이 아니라, 서로 다른 로봇과 환경에서 공통으로 쓸 수 있는 시각 정보 처리 기반을 마련하려는 시도다.
이번 연구는 Science Robotics 11권 119호에 실렸으며 논문 DOI는 10.1126/scirobotics.aec8218이다. 이벤트 카메라의 빠른 시간 감지 능력을 실제 인식 모델과 연결하는 과정에서, 거의 비어 있는 데이터까지 계산하던 병목을 줄였다는 데 의미가 있다.
자료: 펜실베이니아대학교 공과대학, 펜실베이니아대학교 GRASP 연구소, arXiv