
진화 기록 학습한 DNA 언어모델…UC버클리 'GPN-Star' 개발
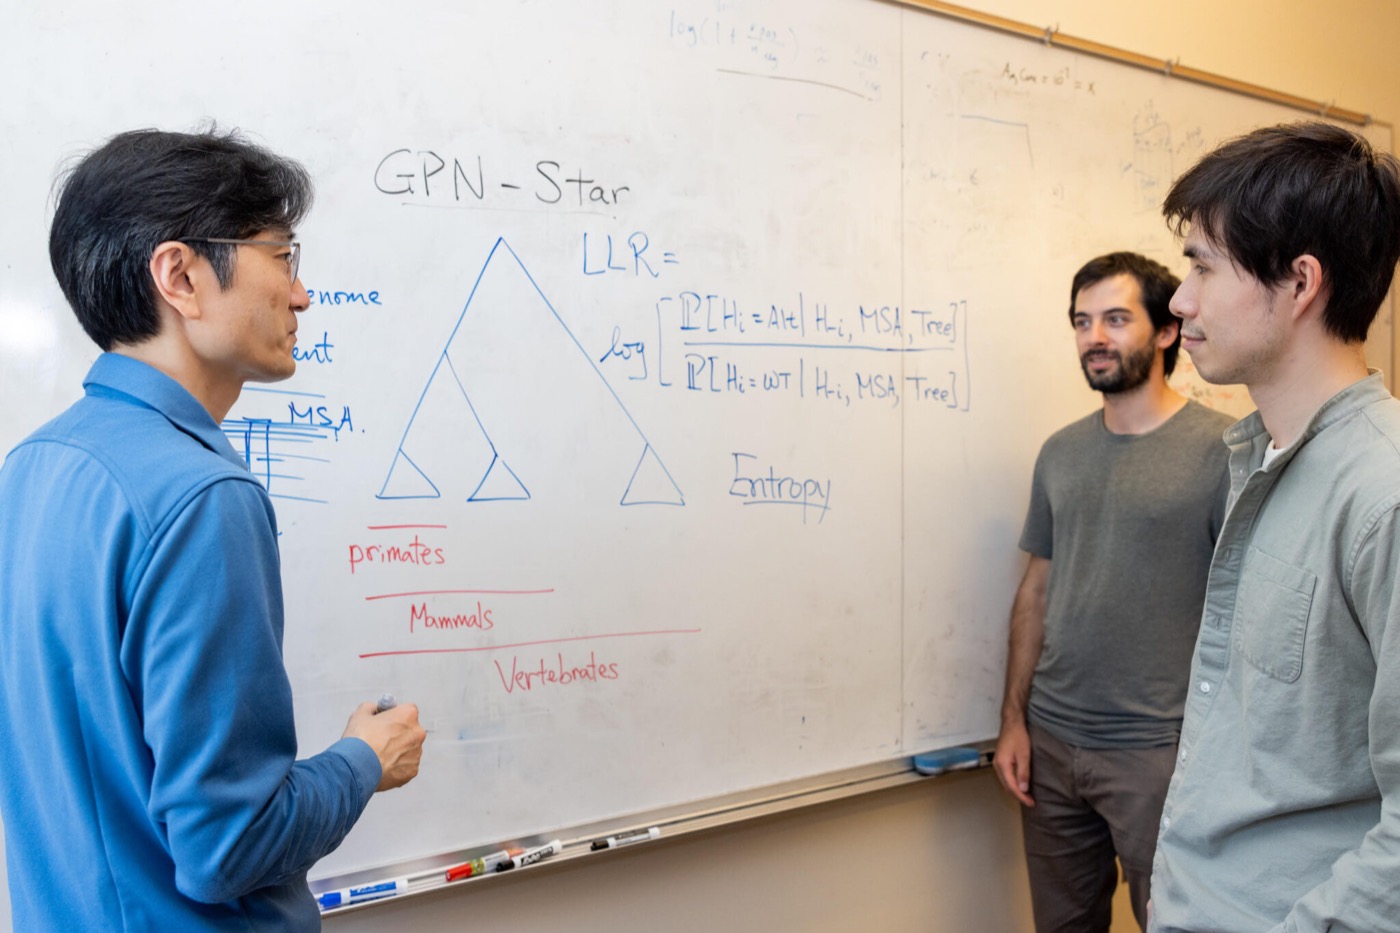
여러 생물 종의 유전체를 나란히 맞춰 놓은 자료로 학습해, 사람 유전체에서 질병과 연관된 변이를 골라내는 인공지능(AI) 모델이 나왔다. 거대 모델보다 학습에 드는 계산 자원이 훨씬 적다는 점이 특징이다.
미국 캘리포니아대 버클리(UC버클리) 연구진은 진화 과정의 보존 정보를 활용하는 유전체 언어모델 ‘GPN-Star’를 개발해 9월 9일 국제 학술지 네이처에 발표했다. 연구는 미국 국립보건원(NIH) 지원을 일부 받았다.
정렬된 유전체를 학습 재료로
유전체 언어모델은 자연어 대신 DNA 염기 서열(A·C·G·T 네 글자의 배열)을 대량으로 학습해 유전체의 ‘문법’을 익히는 모델이다. 기존 모델은 대개 서로 맞춰지지 않은 개별 종의 유전체를 그대로 학습한다. 올해 초 공개된 대형 모델 에보2(Evo 2)는 10만종이 넘는 생물의 유전체를 학습하는 데 고성능 엔비디아 프로세서 2000개와 수개월을 썼다.
연구진은 대신 전유전체 정렬(WGA)을 학습 재료로 삼았다. 수백 종의 유전체를 특정 한 종의 유전체에 맞춰 대응 관계를 찾아 놓은 자료다. 사람 유전체를 기준으로 다른 종들을 맞추면 진화 과정에서 어디가 보존됐고 어디가 바뀌었는지가 드러난다. 보존 영역을 찾는 일을 정렬 자료가 이미 해 놓은 셈이라, GPN-Star는 프로세서 몇 개로 며칠, 짧으면 몇 시간에 학습된다. 기능이 없는 이른바 ‘정크 DNA’에 휘둘릴 가능성도 줄어든다.
연구를 이끈 윤 송(Yun Song) UC버클리 컴퓨터과학·통계학 교수는 “모델이 무엇이 중요한지 스스로 알아내기를 바라는 대신, 생물학적 지식을 써서 모델을 개선해야 한다는 것이 우리 접근”이라고 말했다.
진화 시간대에 따라 잘 맞히는 변이가 달랐다
연구진은 사람 유전체를 기준으로 영장류, 포유류, 척추동물 등 서로 다른 진화 시간대를 담은 정렬 자료 세 가지로 모델을 각각 학습했다.
그 결과 긴 진화 시간대를 학습한 모델은 단백질을 바꾸는 드문 변이의 영향을 더 잘 예측했다. 반면 진화 시간대가 짧은 영장류 자료로 학습한 모델은 조현병 위험처럼 여러 변이가 얽힌 복합 형질에서 비암호화 영역 변이의 영향을 더 잘 예측했다. 공동 제1저자인 청중 예(Chengzhong Ye) UC버클리 통계학 대학원생은 “서로 다른 진화 시간대에서 학습한 모델이 각기 다른 종류의 변이를 해석하는 데 최적화돼 있었다”며 “일부 유전체 요소가 다른 것보다 훨씬 빨리 진화하기 때문에 진화생물학 측면에서도 납득이 된다”고 말했다.
연구진은 논문과 함께 유전체 전체에 대한 예측값도 공개했다. 유전 형질에 영향이 클 만한 변이를 짚어주는 자료로, 생물학자들이 실험할 유전자와 조절 영역의 우선순위를 정하는 데 쓸 수 있다. 공동 제1저자인 곤살로 베네가스(Gonzalo Benegas)는 “더 많은 사람이 이 모델을 다룰수록 모델이 좋아질 것”이라고 말했다.
자료: UC버클리