
적은 컴퓨팅으로 진화를 읽다 — GPN-Star가 던지는 질문
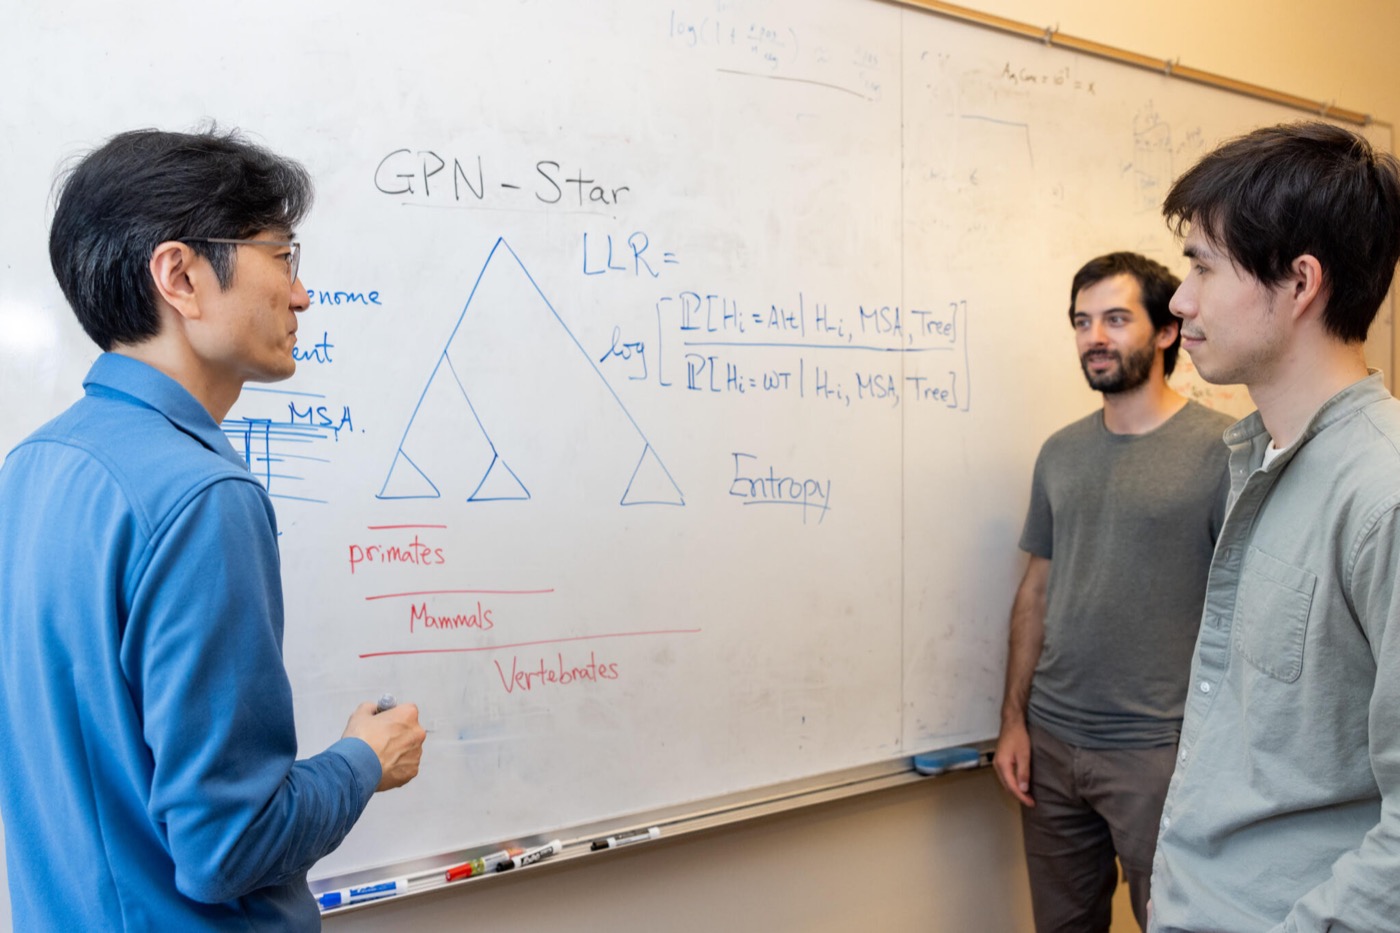
UC버클리 연구진이 최근 네이처에 공개한 유전체 언어모델(genome language model, 사람이 쓰는 문장 대신 DNA 염기서열을 '언어'처럼 학습해 그 안의 규칙을 찾아내는 인공지능) 'GPN-Star'를 보면서 내 눈길을 끈 것은 결과의 정확도보다 학습 방식이었다. 수백 종의 유전체를 사람 유전체 기준으로 미리 정렬(alignment, 여러 생물종의 DNA를 같은 위치끼리 나란히 늘어놓아 비교하는 작업)해 놓은 자료로 학습시키니, 프로세서 몇 개만으로 며칠 만에 학습이 끝났다고 한다. 요즘 인공지능 뉴스의 문법은 대개 '더 큰 모델, 더 많은 GPU'인데, 이 연구는 정반대 방향에서 성과를 냈다는 점에서 다시 볼 필요가 있다.
정렬이 대신해 준 일
생물정보학에서는 오래전부터 여러 종의 유전체를 겹쳐 놓고 오랜 진화에도 잘 안 바뀌는 자리, 이른바 보존 영역(conserved region)을 찾아 왔다. 잘 안 바뀐다는 것은 그 자리가 생명 유지에 중요해서 함부로 바뀌면 도태됐다는 뜻으로 해석되기 때문이다. 단백질 구조를 예측하는 인공지능이 여러 생물종의 서열 비교 자료를 활용해 계산량을 크게 줄인 사례에서 보듯, 정렬 자료 자체에 이미 '무엇이 중요한 자리인지'에 대한 힌트가 압축돼 있다. GPN-Star는 이 힌트를 모델이 방대한 데이터에서 스스로 재발견하게 두는 대신 처음부터 입력에 심어 준 셈이다. 학습이 가벼워진 것은 우연이 아니라 이 설계의 당연한 결과라고 본다.
거대 모델 경쟁에 던지는 질문
나는 이 결과가 국내 연구·산업 생태계에 주는 메시지가 크다고 생각한다. 유전체 인공지능 경쟁이 흔히 '누가 더 큰 GPU 클러스터를 갖췄는가'의 싸움으로 그려지지만, 이번 사례는 도메인 지식을 데이터 설계에 얼마나 촘촘히 녹였는지가 승부를 가를 수 있음을 보여준다. 컴퓨팅 자원에서 밀리는 국내 연구기관이나 중소 바이오기업이 오히려 눈여겨봐야 할 접근이다. 다만 아쉬운 지점도 분명하다. 정렬 자료의 질과 종 구성에 결과가 좌우될 수밖에 없는 구조여서, 특정 질환 관련 변이의 기능을 얼마나 신뢰성 있게 예측하는지는 이번 발표만으로 단정하기 어렵다. 임상 적용을 말하기 전에 다양한 질환군에서의 검증이 뒤따라야 한다는 뜻이다. 그럼에도 이 연구는 '크게 만들 수 없다면 영리하게 설계하라'는 오래된 원칙을 인공지능 시대에 다시 증명했다는 점에서, 우리 연구 현장이 곱씹어 볼 가치가 있다고 본다.