
농생명 데이터, AI에게 검증을 맡긴 다음의 질문
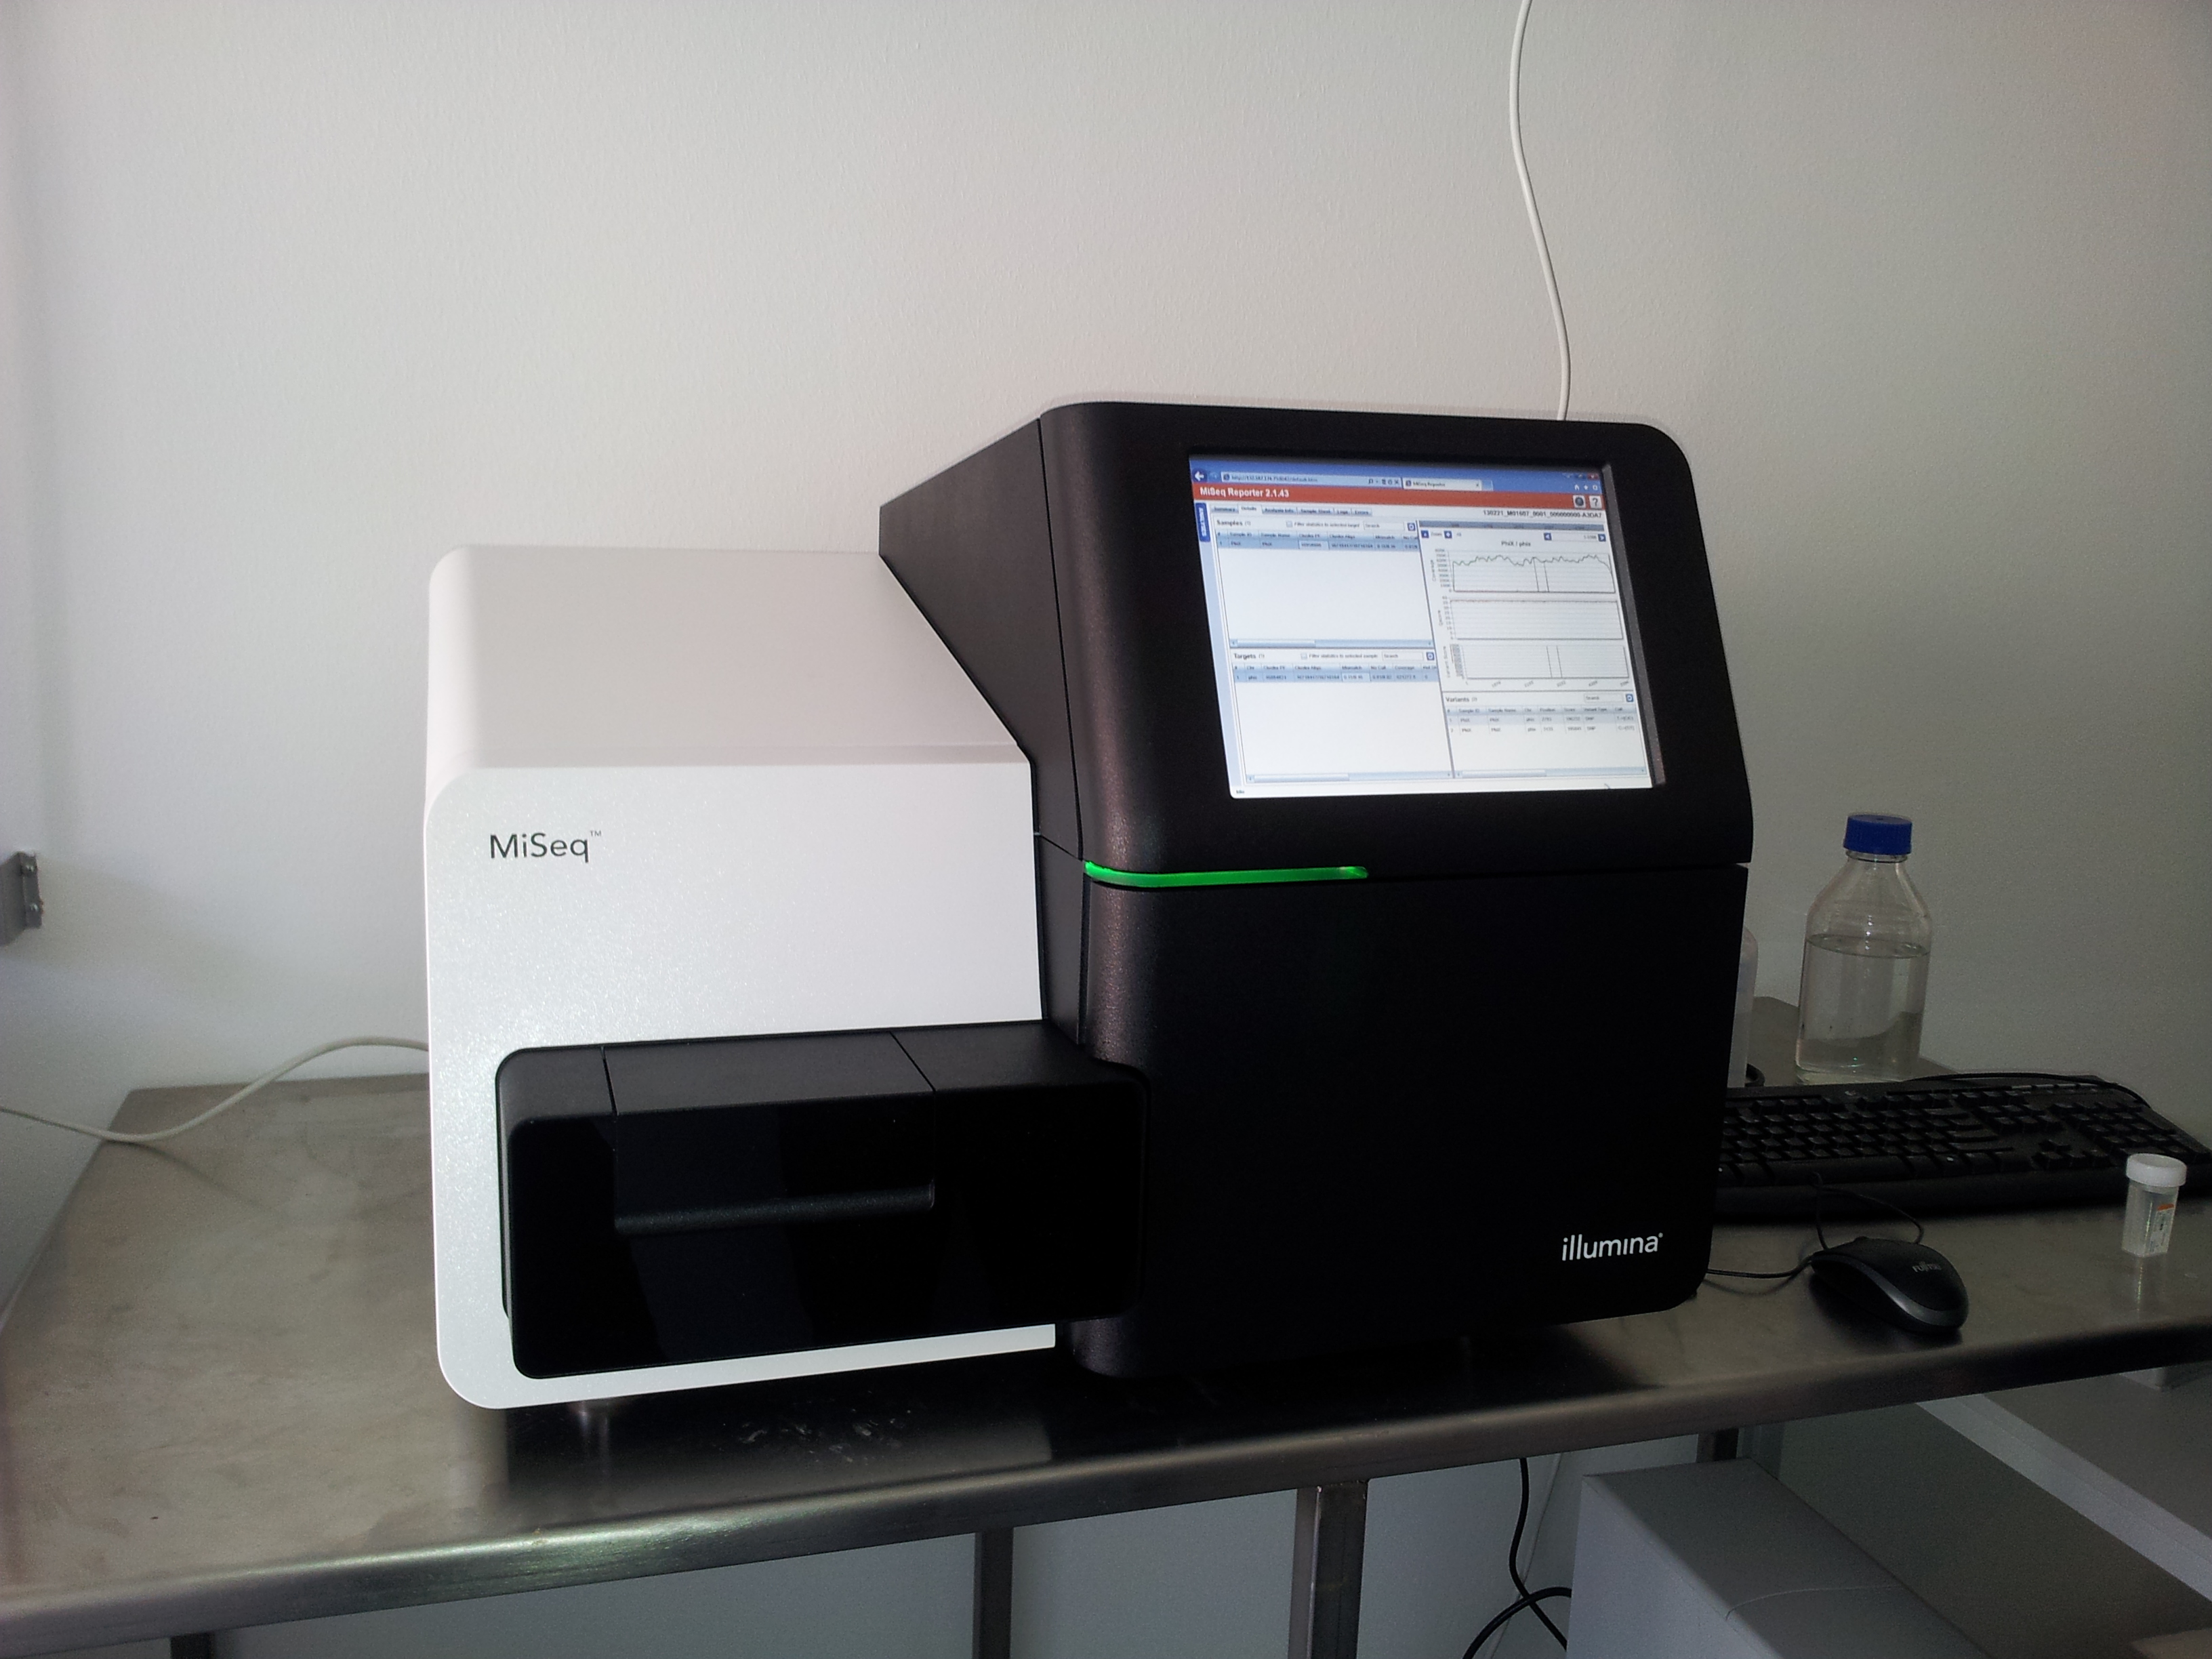
농촌진흥청이 25일 밝힌 농생명 데이터 품질관리 자동화 기술을 보고 필자가 먼저 떠올린 것은 "이게 왜 이제서야 나왔을까"라는 질문이었다. 유전체(genome, 한 생물이 가진 DNA 전체 정보)와 전사체(transcriptome, 특정 시점에 세포에서 실제로 발현되는 RNA 정보 전체) 데이터는 매년 20%씩 늘어난다고 한다. 연구자가 실험 결과를 내놓기 전에 그 데이터에 잡음이나 오류가 없는지 걸러내는 작업, 즉 품질검증은 그동안 대부분 사람의 손과 눈에 의존해 왔다. 데이터는 기하급수로 쌓이는데 검증은 여전히 사람 속도로 가는 불균형, 이 불균형이 이번 발표의 진짜 배경이라고 본다.
왜 지금인가
사실 생명과학 데이터의 자동 품질관리는 국내만의 고민이 아니다. 차세대 시퀀싱(NGS) 기술이 보급되면서 유전체·전사체 데이터를 만들어내는 비용은 지난 10여 년간 꾸준히 떨어졌고, 그 결과 전 세계 공공 유전체 데이터베이스들은 이미 오래전부터 이상치 탐지나 노이즈 필터링을 자동화하는 파이프라인을 도입해 왔다. 농생명 분야는 상대적으로 이런 흐름에 한 걸음 늦게 합류한 축에 속한다고 본다. 작물·가축을 다루는 연구는 실험 조건이 표준화되기 어렵고 현장 변수가 많아 품질관리 기준을 세우기가 까다롭기 때문이다. 이번에 슈퍼컴퓨터와 AI를 결합한 4단계 체계가 나온 것은, 그런 어려움에도 자동화가 이제 현실적인 선택지가 됐다는 신호로 읽힌다.
연구자 해방, 그다음 질문
연구자가 검증 부담에서 벗어나는 것 자체는 반길 일이다. 데이터 정제에 들어가는 시간은 새로운 발견을 위한 시간이 아니기 때문이다. 다만 이 기술의 성패는 "얼마나 빠르냐"가 아니라 "얼마나 믿을 수 있냐"에서 갈릴 것이라고 본다. 자동화된 품질관리가 걸러내지 못한 오류가 하류의 연구 결과, 나아가 품종 개발이나 정책 판단까지 흘러간다면 그 피해는 사람이 검증했을 때보다 눈에 잘 띄지 않은 채 누적될 수 있다. 그래서 2028년 외부 연구 현장 개방 이전까지 남은 시간을, 검증 알고리즘 자체의 오탐·누락률을 공개적으로 다듬는 데 써야 한다고 본다. 그래야 개방 이후에도 신뢰가 함께 따라간다.
농생명 데이터는 식량안보와 직결되는 자원이다. 검증을 AI에 맡기는 것이 종착점이 아니라, 그 AI를 다시 누가 어떻게 검증하느냐가 다음 과제라는 점을 이번 발표를 보며 짚어두고 싶다.